

Trong thế giới dữ liệu không ngừng biến động của năm 2026, khả năng hiểu và phân tích các con số trở thành một kỹ năng không thể thiếu. Một trong những công cụ cơ bản và quyền năng nhất trong lĩnh vực thống kê mô tả chính là phương sai. Nắm vững công thức phương sai không chỉ giúp bạn đánh giá mức độ phân tán của dữ liệu mà còn là nền tảng để đưa ra những quyết định sáng suốt trong nhiều lĩnh vực từ kinh tế, tài chính đến nghiên cứu khoa học và y tế. Bài viết này sẽ đi sâu vào định nghĩa, các loại công thức phương sai, cách tính toán chi tiết và ý nghĩa thực tiễn của nó trong kỷ nguyên số.
Phương Sai Là Gì? Ý Nghĩa Cơ Bản
Phương sai (Variance) là một đại lượng thống kê dùng để đo lường mức độ phân tán của một tập hợp dữ liệu so với giá trị trung bình của nó. Nói cách khác, phương sai cho chúng ta biết các điểm dữ liệu phân bổ rộng hay hẹp xung quanh giá trị trung bình. Nếu phương sai lớn, điều đó có nghĩa là các giá trị trong tập dữ liệu có xu hướng nằm xa giá trị trung bình và phân tán rộng. Ngược lại, nếu phương sai nhỏ, các giá trị có xu hướng tập trung gần giá trị trung bình hơn.
Ý nghĩa cốt lõi của phương sai nằm ở khả năng định lượng sự biến động. Trong kinh doanh, phương sai có thể giúp đánh giá rủi ro của một khoản đầu tư (mức độ biến động giá cổ phiếu). Trong khoa học, nó giúp xác định tính nhất quán của các kết quả thí nghiệm. Trong nghiên cứu xã hội, phương sai cho biết sự đa dạng ý kiến trong một nhóm đối tượng. Đây là một chỉ số mạnh mẽ để hiểu rõ hơn về tính chất của dữ liệu bạn đang làm việc.
Các Loại Phương Sai Phổ Biến và Công Thức Cốt Lõi
Trong thống kê, chúng ta thường gặp hai loại phương sai chính tùy thuộc vào việc chúng ta đang xử lý tổng thể dữ liệu hay chỉ một mẫu con của nó:
Phương Sai Tổng Thể (Population Variance)
Phương sai tổng thể, ký hiệu là \(\sigma^2\) (sigma bình phương), được sử dụng khi chúng ta có thể thu thập dữ liệu từ toàn bộ quần thể (tất cả các phần tử có thể có). Đây là giá trị lý tưởng nhưng thường khó đạt được trong thực tế.
Công thức phương sai tổng thể:
\(\sigma^2 = \frac{\sum_{i=1}^{N} (x_i – \mu)^2}{N}\)
- \(x_i\): Giá trị của từng phần tử trong tổng thể.
- \(\mu\): Giá trị trung bình của tổng thể.
- \(N\): Kích thước của tổng thể (tổng số phần tử).
- \(\sum\): Ký hiệu tổng.
Phương Sai Mẫu (Sample Variance)
Phương sai mẫu, ký hiệu là \(s^2\), được tính toán khi chúng ta chỉ có một mẫu con được lấy từ tổng thể. Đây là loại phương sai thường được sử dụng hơn trong hầu hết các nghiên cứu và phân tích dữ liệu thực tế.
Công thức phương sai mẫu:
\(s^2 = \frac{\sum_{i=1}^{n} (x_i – \bar{x})^2}{n-1}\)
- \(x_i\): Giá trị của từng phần tử trong mẫu.
- \(\bar{x}\): Giá trị trung bình của mẫu.
- \(n\): Kích thước của mẫu (số phần tử trong mẫu).
- \(\sum\): Ký hiệu tổng.
Sự khác biệt quan trọng giữa hai công thức phương sai này là mẫu số. Trong công thức phương sai mẫu, chúng ta chia cho \(n-1\) thay vì \(n\). Điều này được gọi là hiệu chỉnh Bessel và được thực hiện để cung cấp một ước lượng không chệch (unbiased estimate) của phương sai tổng thể từ phương sai mẫu. Khi kích thước mẫu \(n\) lớn, sự khác biệt giữa \(n\) và \(n-1\) trở nên không đáng kể.
Công Thức Phương Sai Cho Dữ Liệu Không Ghép Nhóm (Dữ Liệu Thô)
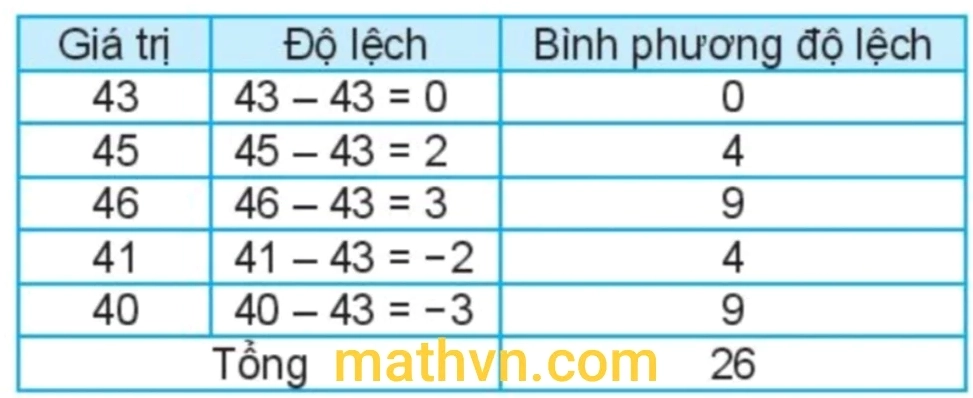
Dữ liệu không ghép nhóm, hay còn gọi là dữ liệu thô, là tập hợp các giá trị riêng lẻ chưa được tổ chức thành các lớp hay khoảng. Việc tính phương sai cho loại dữ liệu này khá đơn giản, bao gồm các bước sau:
- Tính giá trị trung bình (mean): Cộng tất cả các giá trị trong tập dữ liệu rồi chia cho tổng số giá trị. Ký hiệu là \(\bar{x}\) (cho mẫu) hoặc \(\mu\) (cho tổng thể).
- Tính độ lệch so với giá trị trung bình: Trừ đi giá trị trung bình từ mỗi giá trị dữ liệu (\(x_i – \bar{x}\) hoặc \(x_i – \mu\)).
- Bình phương các độ lệch: Lấy bình phương từng kết quả ở bước 2 để loại bỏ các giá trị âm và làm nổi bật các độ lệch lớn.
- Tính tổng các bình phương độ lệch: Cộng tất cả các giá trị bình phương lại với nhau.
- Chia tổng cho số lượng phần tử (hoặc số lượng phần tử trừ 1):
- Đối với tổng thể: Chia cho \(N\).
- Đối với mẫu: Chia cho \(n-1\).
Ví dụ minh họa:
Giả sử chúng ta có một mẫu điểm số bài kiểm tra của 5 học sinh: 7, 8, 9, 6, 10.
- Giá trị trung bình (\(\bar{x}\)): \(\frac{7+8+9+6+10}{5} = \frac{40}{5} = 8\)
- Độ lệch so với trung bình:
- 7 – 8 = -1
- 8 – 8 = 0
- 9 – 8 = 1
- 6 – 8 = -2
- 10 – 8 = 2
- Bình phương các độ lệch:
- (-1)^2 = 1
- (0)^2 = 0
- (1)^2 = 1
- (-2)^2 = 4
- (2)^2 = 4
- Tổng các bình phương độ lệch: \(1 + 0 + 1 + 4 + 4 = 10\)
- Tính phương sai mẫu (\(s^2\)): \(\frac{10}{5-1} = \frac{10}{4} = 2.5\)
Vậy phương sai của mẫu điểm số này là 2.5.
Công Thức Phương Sai Cho Dữ Liệu Ghép Nhóm
Khi dữ liệu quá lớn hoặc đã được tổ chức thành các khoảng (lớp) với tần số tương ứng, chúng ta sử dụng công thức phương sai cho dữ liệu ghép nhóm. Việc này giúp đơn giản hóa quá trình tính toán.
Công thức phương sai mẫu cho dữ liệu ghép nhóm:
\(s^2 = \frac{\sum_{i=1}^{k} f_i (m_i – \bar{x})^2}{n-1}\)
- \(f_i\): Tần số của lớp thứ \(i\).
- \(m_i\): Giá trị điểm giữa (midpoint) của lớp thứ \(i\).
- \(\bar{x}\): Giá trị trung bình của mẫu (được tính từ dữ liệu ghép nhóm: \(\bar{x} = \frac{\sum_{i=1}^{k} f_i m_i}{n}\)).
- \(n\): Tổng số quan sát (\(n = \sum_{i=1}^{k} f_i\)).
- \(k\): Số lượng các lớp.
Ví dụ minh họa:
Giả sử chúng ta có dữ liệu về số giờ học của sinh viên trong một tuần:
| Khoảng giờ học | Tần số (f_i) | Điểm giữa (m_i) |
|---|---|---|
| [0 – 5) | 3 | 2.5 |
| [5 – 10) | 7 | 7.5 |
| [10 – 15) | 5 | 12.5 |
- Tổng số quan sát (n): \(3 + 7 + 5 = 15\)
- Tính giá trị trung bình (\(\bar{x}\)):
\(\bar{x} = \frac{(3 \times 2.5) + (7 \times 7.5) + (5 \times 12.5)}{15} = \frac{7.5 + 52.5 + 62.5}{15} = \frac{122.5}{15} \approx 8.17\) - Tính \(f_i (m_i – \bar{x})^2\) cho từng lớp:
- Lớp 1: \(3 \times (2.5 – 8.17)^2 = 3 \times (-5.67)^2 = 3 \times 32.1489 \approx 96.4467\)
- Lớp 2: \(7 \times (7.5 – 8.17)^2 = 7 \times (-0.67)^2 = 7 \times 0.4489 \approx 3.1423\)
- Lớp 3: \(5 \times (12.5 – 8.17)^2 = 5 \times (4.33)^2 = 5 \times 18.7489 \approx 93.7445\)
- Tổng các giá trị \(f_i (m_i – \bar{x})^2\): \(96.4467 + 3.1423 + 93.7445 \approx 193.3335\)
- Tính phương sai mẫu (\(s^2\)): \(s^2 = \frac{193.3335}{15-1} = \frac{193.3335}{14} \approx 13.81\)
Vậy phương sai của dữ liệu ghép nhóm này là khoảng 13.81.
Mối Quan Hệ Giữa Phương Sai và Độ Lệch Chuẩn
Khi đã tính toán được phương sai, bước tiếp theo thường là tính độ lệch chuẩn. Độ lệch chuẩn (Standard Deviation) là căn bậc hai của phương sai.
Công thức độ lệch chuẩn tổng thể: \(\sigma = \sqrt{\sigma^2}\)
Công thức độ lệch chuẩn mẫu: \(s = \sqrt{s^2}\)
Mặc dù cả phương sai và độ lệch chuẩn đều đo lường sự phân tán, độ lệch chuẩn thường được ưa dùng hơn trong việc diễn giải vì nó có cùng đơn vị đo với dữ liệu gốc và giá trị trung bình. Điều này giúp việc so sánh và hình dung sự phân tán trở nên trực quan hơn rất nhiều.
Ví dụ, nếu điểm số trung bình là 8 và phương sai là 2.5, thì độ lệch chuẩn là \(\sqrt{2.5} \approx 1.58\). Điều này có nghĩa là các điểm số trung bình lệch khỏi giá trị trung bình khoảng 1.58 điểm.
Ý Nghĩa Thực Tiễn của Phương Sai trong Phân Tích Dữ Liệu
Công thức phương sai và độ lệch chuẩn là những công cụ vô giá trong nhiều lĩnh vực:
- Kinh tế và Tài chính: Đánh giá mức độ rủi ro của các khoản đầu tư. Một cổ phiếu có phương sai lợi nhuận cao sẽ có rủi ro cao hơn (biến động nhiều hơn) so với một cổ phiếu có phương sai thấp.
- Quản lý Chất lượng: Kiểm soát chất lượng sản phẩm. Một phương sai nhỏ trong kích thước hoặc trọng lượng sản phẩm cho thấy quy trình sản xuất ổn định và đáng tin cậy.
- Y học và Sinh học: Nghiên cứu sự biến đổi gen, đáp ứng thuốc ở bệnh nhân hoặc sự phân bố của một bệnh trong quần thể.
- Khoa học Xã hội và Tâm lý học: Phân tích sự đa dạng trong các kết quả khảo sát, thái độ, hoặc hành vi của các nhóm đối tượng.
- Trong Thống kê Suy luận: Phương sai là thành phần cốt lõi trong nhiều kiểm định thống kê như kiểm định ANOVA, kiểm định t, và hồi quy tuyến tính, giúp xác định xem sự khác biệt giữa các nhóm có ý nghĩa thống kê hay không.
Hiểu được phương sai giúp các nhà phân tích dữ liệu không chỉ mô tả hiện trạng mà còn dự đoán và đưa ra các can thiệp hiệu quả hơn.
Hướng Dẫn Thực Hành Tính Phương Sai Bằng Phần Mềm
Trong thời đại dữ liệu lớn (Big Data) như năm 2026, việc tính toán phương sai bằng tay cho các tập dữ liệu lớn là không khả thi. May mắn thay, có rất nhiều phần mềm thống kê mạnh mẽ có thể thực hiện công việc này một cách nhanh chóng và chính xác.
Sử dụng SPSS để tính Phương sai và Thống kê mô tả khác
SPSS (Statistical Package for the Social Sciences) là một trong những phần mềm phổ biến nhất được sử dụng cho phân tích thống kê. Để tính phương sai trong SPSS, bạn thường sử dụng chức năng Descriptive Statistics (Thống kê mô tả).
- Mở dữ liệu của bạn trong SPSS.
- Vào menu Analyze > Descriptive Statistics > Frequencies… hoặc Analyze > Descriptive Statistics > Descriptives…
- Trong hộp thoại, chuyển biến mà bạn muốn tính phương sai sang ô Variables(s).
- Nhấp vào nút Statistics….
- Trong hộp thoại Frequencies: Statistics hoặc Descriptives: Options, chọn mục Variance và Standard deviation (độ lệch chuẩn). Bạn cũng có thể chọn Mean, Median, Mode, Range, v.v.
- Nhấp Continue rồi OK.
Kết quả đầu ra sẽ hiển thị phương sai và các thống kê mô tả khác cho biến bạn đã chọn. Việc sử dụng phần mềm không chỉ tiết kiệm thời gian mà còn giảm thiểu lỗi tính toán, đặc biệt quan trọng với các tập dữ liệu phức tạp liên quan đến các biến trung gian hoặc điều tiết.
Các Yếu Tố Ảnh Hưởng Đến Phương Sai
Hiểu các yếu tố ảnh hưởng đến phương sai là rất quan trọng để đưa ra kết luận chính xác từ phân tích dữ liệu:
- Kích thước mẫu (n): Kích thước mẫu càng lớn, ước lượng phương sai mẫu càng gần với phương sai tổng thể thực sự và có độ tin cậy cao hơn.
- Sự phân bố dữ liệu: Dữ liệu có phân bố lệch (skewed) hoặc có nhiều đỉnh (multimodal) thường có phương sai lớn hơn so với dữ liệu phân bố đối xứng và tập trung.
- Giá trị ngoại lai (outliers): Các giá trị quá lớn hoặc quá nhỏ so với phần còn lại của dữ liệu có thể làm tăng đáng kể phương sai, làm sai lệch kết quả. Việc phát hiện và xử lý các giá trị ngoại lai là một bước quan trọng trong tiền xử lý dữ liệu.
- Đơn vị đo lường: Phương sai nhạy cảm với đơn vị đo lường. Nếu bạn thay đổi đơn vị đo (ví dụ từ mét sang centimet), giá trị phương sai sẽ thay đổi theo bình phương của hệ số chuyển đổi. Đây là một lý do khác khiến độ lệch chuẩn thường được ưa dùng hơn vì nó giữ nguyên đơn vị.
Những Sai Lầm Thường Gặp Khi Sử Dụng Phương Sai
Ngay cả những chuyên gia cũng có thể mắc phải một số sai lầm khi làm việc với phương sai:
- Hiểu sai ý nghĩa: Nhiều người nhầm lẫn phương sai với phạm vi (range) hoặc độ lệch trung bình tuyệt đối. Phương sai tập trung vào bình phương các độ lệch, mang lại trọng số lớn hơn cho các giá trị xa trung bình hơn.
- Lựa chọn công thức không phù hợp: Sử dụng công thức phương sai tổng thể cho dữ liệu mẫu hoặc ngược lại có thể dẫn đến kết quả sai lệch, đặc biệt với các mẫu nhỏ. Luôn đảm bảo bạn sử dụng công thức chính xác cho ngữ cảnh của mình.
- Bỏ qua độ lệch chuẩn: Chỉ nhìn vào phương sai mà không xem xét độ lệch chuẩn có thể gây khó khăn trong việc diễn giải. Độ lệch chuẩn cung cấp một cái nhìn trực quan và dễ hiểu hơn về sự phân tán vì nó có cùng đơn vị với dữ liệu gốc.
- Không kiểm tra dữ liệu: Bỏ qua việc kiểm tra các giả định về phân bố hoặc sự hiện diện của giá trị ngoại lai có thể làm cho phương sai bị thổi phồng hoặc đánh giá thấp một cách không chính xác.
Kết Luận
Công thức phương sai là một viên gạch nền tảng trong bộ công cụ của bất kỳ nhà phân tích dữ liệu hay người ra quyết định nào. Từ việc hiểu rõ định nghĩa cơ bản đến việc áp dụng các công thức phương sai cho dữ liệu thô và dữ liệu ghép nhóm, cùng với việc nhận thức về mối liên hệ chặt chẽ với độ lệch chuẩn, bạn đã trang bị cho mình kiến thức cần thiết để đánh giá chính xác mức độ phân tán và biến động của dữ liệu. Trong bối cảnh phát triển nhanh chóng của khoa học dữ liệu năm 2026, việc làm chủ phương sai và các kỹ thuật thống kê liên quan sẽ giúp bạn tự tin hơn trong việc đưa ra những phân tích sâu sắc và đáng tin cậy.

Để lại một bình luận